快狗打車實時數(shù)倉演進(jìn)之路 數(shù)據(jù)處理與存儲服務(wù)的架構(gòu)升級
隨著快狗打車業(yè)務(wù)的快速增長,對實時數(shù)據(jù)的需求日益迫切。數(shù)據(jù)處理和存儲服務(wù)作為實時數(shù)倉的核心模塊,經(jīng)歷了從傳統(tǒng)批處理到實時流處理的演進(jìn)。
初始階段,快狗打車采用基于Hadoop的離線數(shù)倉架構(gòu),數(shù)據(jù)通過T+1方式批量處理,延遲高且無法滿足實時業(yè)務(wù)場景。隨著用戶規(guī)模擴大,實時調(diào)度、定價策略和運營分析對數(shù)據(jù)時效性要求提升。
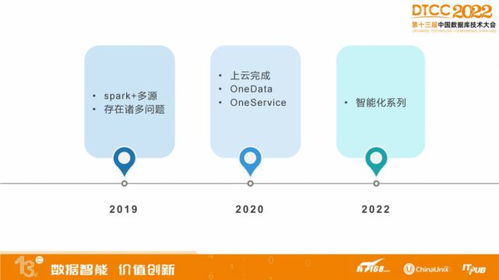
快狗打車數(shù)據(jù)處理服務(wù)演進(jìn)過程主要分為三個關(guān)鍵階段:
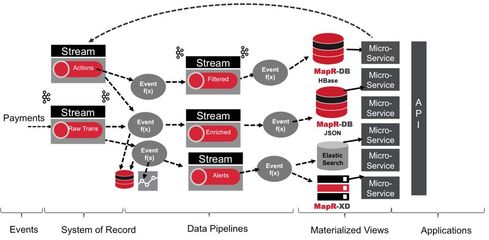
第一階段,引入Kafka作為數(shù)據(jù)總線,將業(yè)務(wù)系統(tǒng)產(chǎn)生的訂單、位置和用戶行為數(shù)據(jù)實時采集到消息隊列。數(shù)據(jù)處理層采用Spark Streaming進(jìn)行初步的ETL操作,實現(xiàn)數(shù)據(jù)清洗和格式標(biāo)準(zhǔn)化。
第二階段,構(gòu)建分層數(shù)據(jù)處理架構(gòu)。基于Lambda架構(gòu),同時支持批處理和流處理兩條數(shù)據(jù)通道。實時流處理使用Flink替換部分Spark Streaming組件,提供更低的處理延遲和Exactly-Once語義保障,滿足訂單狀態(tài)追蹤、司機位置更新等核心業(yè)務(wù)的實時需求。
第三階段,實現(xiàn)流批一體和智能化處理。借助Flink的流批統(tǒng)一引擎,簡化數(shù)據(jù)處理邏輯;引入機器學(xué)習(xí)模型,對實時流量進(jìn)行異常檢測和預(yù)測分析;建立數(shù)據(jù)質(zhì)量監(jiān)控體系,確保數(shù)據(jù)處理過程的準(zhǔn)確性和完整性。
在數(shù)據(jù)存儲服務(wù)方面,演進(jìn)路徑同樣清晰:
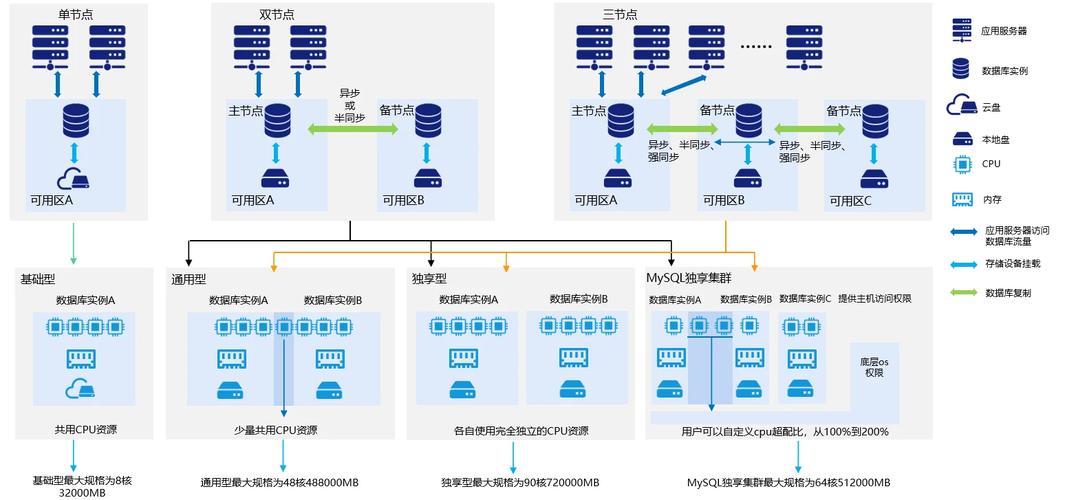
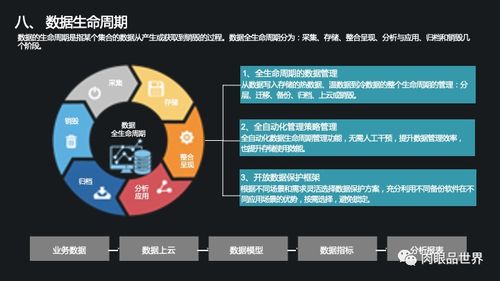
初期使用HDFS和Hive存儲歷史數(shù)據(jù),MySQL存儲維度表。隨著實時查詢需求增加,引入ClickHouse作為OLAP引擎,支持多維度實時分析。針對不同的數(shù)據(jù)訪問模式,建設(shè)了多級存儲體系:
- 熱數(shù)據(jù)存儲在Redis和Elasticsearch中,支持毫秒級查詢響應(yīng)
- 溫數(shù)據(jù)存儲在ClickHouse,支持復(fù)雜分析查詢
- 冷數(shù)據(jù)歸檔至HDFS,滿足合規(guī)和長期存儲需求
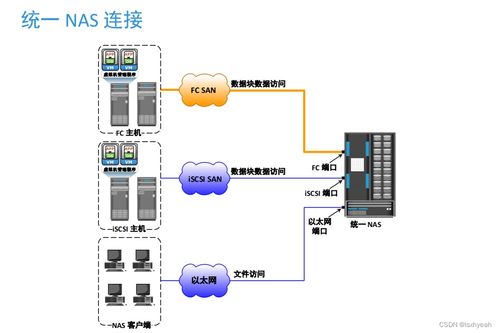
通過構(gòu)建統(tǒng)一數(shù)據(jù)服務(wù)層,對外提供標(biāo)準(zhǔn)化的數(shù)據(jù)訪問接口,屏蔽底層存儲差異,降低業(yè)務(wù)方使用門檻。
當(dāng)前,快狗打車實時數(shù)倉每天處理數(shù)十TB數(shù)據(jù),支撐著智能調(diào)度、動態(tài)定價、風(fēng)險控制等核心業(yè)務(wù)場景。數(shù)據(jù)處理延遲從小時級降至秒級,數(shù)據(jù)存儲成本通過分層策略得到有效控制。
快狗打車將持續(xù)優(yōu)化數(shù)據(jù)處理和存儲服務(wù),探索基于云原生的架構(gòu)升級,加強數(shù)據(jù)治理和安全管理,為建設(shè)更加智能、高效的實時數(shù)據(jù)平臺奠定堅實基礎(chǔ)。
如若轉(zhuǎn)載,請注明出處:http://www.hongcheng168.com/product/25.html
更新時間:2026-10-22 23:35:51